VB Reseller Analytics
2026 · Dados e BI
- Função
- Criador e analista de dados
- Resultado
- Dashboard com 27 gráficos em 5 abas, montado por código
Resumo
O VB Reseller Analytics é um estudo de análise de dados de uma distribuidora com 300 revendas. Criei um dashboard comercial com toda a regra de negócio em SQL.
- Problema: o time comercial precisa saber quem vai fechar o mês abaixo da meta, a tempo de ligar antes.
- O que eu fiz: montei o painel com PostgreSQL e Apache Superset. A regra de negócio fica em SQL, e o painel é criado por código.
- Resultado: o painel tem 27 gráficos em cinco abas, uma para cada público, e responde as cinco perguntas do time comercial.
- Stack: PostgreSQL, Apache Superset e Docker.
- Origem: estudo próprio, inspirado num caso real, com dados fictícios.
Case completo
5 min de leitura
Contexto
A distribuidora vende por uma rede de revendas, como lojas de bairro, postos e supermercados.
A rede se organiza em quatro níveis: diretoria, regional, carteira do consultor e revenda.
Para manter a rede engajada, a distribuidora roda um programa de pontos. Cada revenda pontua todo mês em quatro indicadores:
- volume, com 100 pontos ao bater a meta e 50 ao passar de 90%;
- recorrência de pedidos, com 60 pontos;
- inadimplência de até 5% do valor vencido, com 60 pontos;
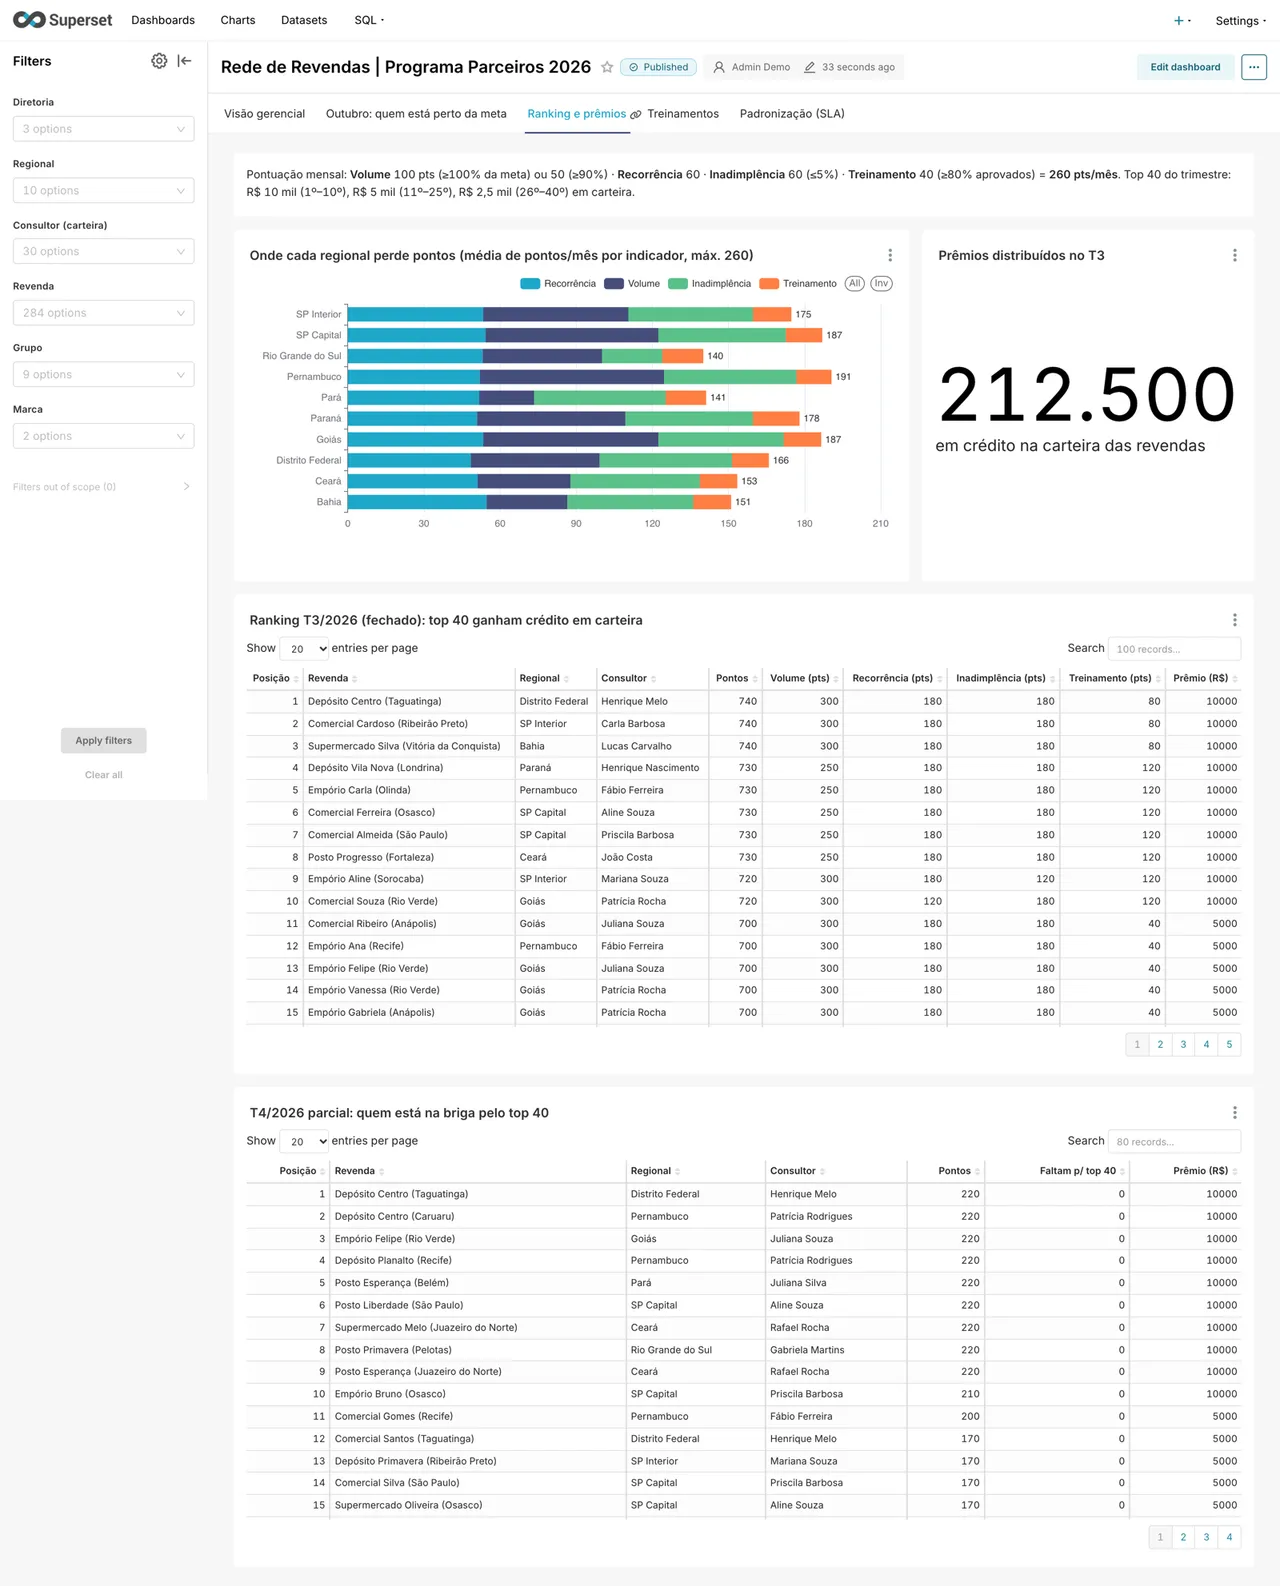
- treinamento, com 40 pontos quando 80% dos funcionários são aprovados.
As 40 revendas com mais pontos no trimestre ganham crédito de R$ 10 mil, R$ 5 mil ou R$ 2,5 mil.
O time comercial precisa responder cinco perguntas:
- Onde a meta não está sendo batida, e se o problema é volume, inadimplência ou treinamento.
- Quem vai fechar o mês abaixo da meta, a tempo de o consultor ligar antes.
- Como está o ranking e quem está perto do top 40.
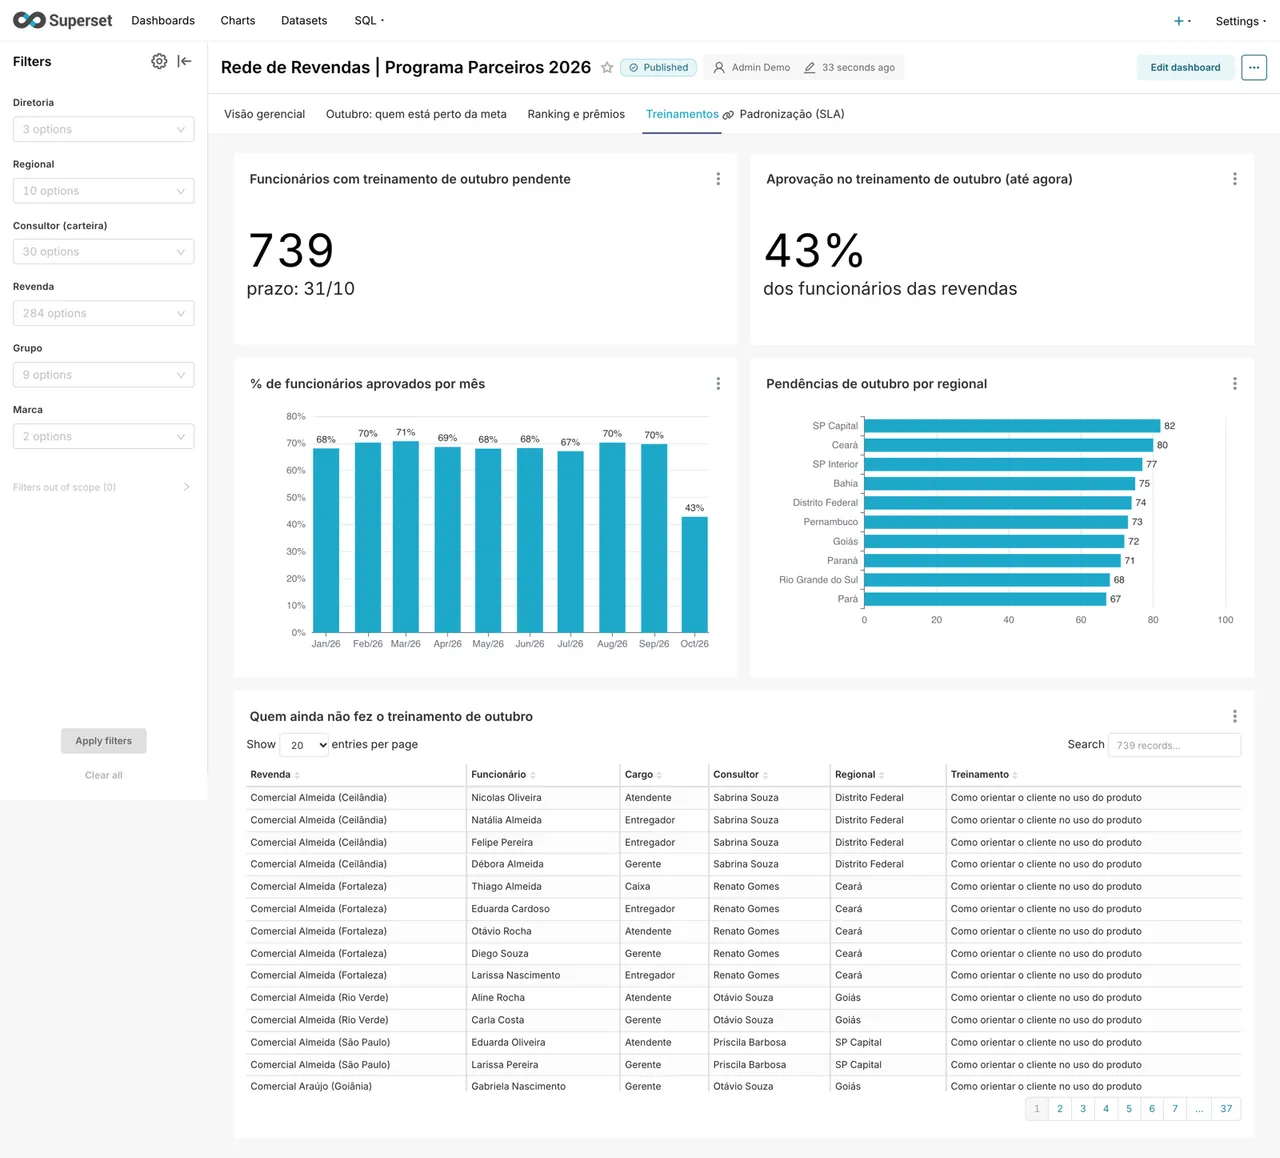
- Quem ainda não fez o treinamento do mês.
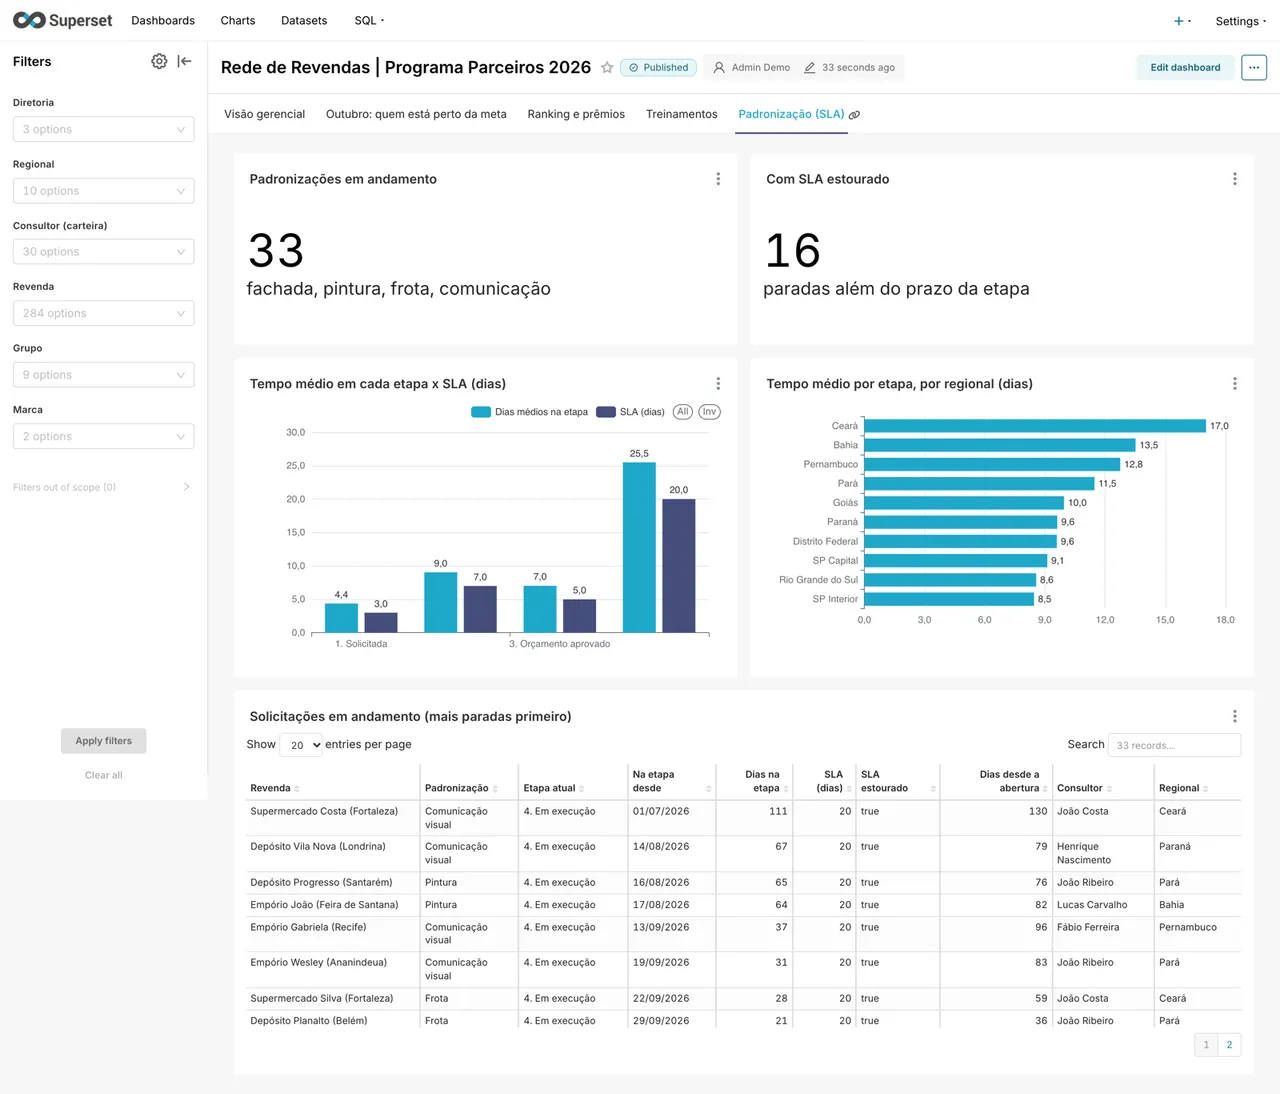
- Quais obras de padronização de loja estão paradas além do prazo.
Criei o projeto para mostrar como eu respondo esse tipo de pergunta com SQL e BI. Os dados são fictícios.
O que eu fiz
Montei a análise com PostgreSQL e Apache Superset, tudo rodando em Docker.
Comecei pelas tabelas. Elas ficam no formato em que sairiam de um sistema de vendas, sem nenhum indicador pronto.
Um analista quase nunca recebe o dado pronto para o gráfico.
Depois criei um gerador de dados com intenção. Cada regional tem um perfil, para que o painel tenha o que mostrar:
- Pará e Ceará vendem bem abaixo da meta;
- o Rio Grande do Sul tem cerca de 18% de inadimplência, contra cerca de 3% no resto da rede;
- o Nordeste demora mais nas obras de padronização;
- o treinamento fica abaixo de 80% em toda a rede.
São 300 revendas, cerca de 18 mil pedidos e 11 mil respostas de treinamento. A seed é fixa, então quem roda vê os mesmos números.
Toda a regra de negócio ficou em views SQL, e não nos gráficos. O Superset só lê o resultado.
Assim a regra é a mesma em qualquer gráfico, no SQL Lab ou numa exportação.
São seis views. A principal cruza revenda e mês e calcula o percentual da meta, a inadimplência, o treinamento e os pontos.
As views usam uma data de referência gravada no banco, e não a data do dia. Os números não mudam sozinhos de um dia para o outro.
Por fim, o dashboard virou código. Um script cria a conexão, os datasets, os 27 gráficos, o layout e os filtros pela API do Superset, sem nenhum clique.
O painel fica versionado no Git e é recriado do zero em segundos.
Ele tem cinco abas, cada uma para um público:
- visão gerencial, para a diretoria e os gerentes regionais;
- quem está perto da meta, para o consultor;
- ranking e prêmios, para todos;
- treinamentos, para o consultor e o RH;
- padronização, para operações.
Os filtros funcionam em cascata. A diretoria limita as regionais, que limitam os consultores e as revendas.
O ranking mostra onde cada regional perde pontos e quem está na briga pelo top 40.
A aba de treinamentos lista quem ainda não fez o treinamento do mês.
A de padronização compara o tempo de cada etapa com o prazo e põe as obras mais paradas no topo.
Detalhe
A aba do consultor responde a pergunta mais urgente: quem não vai bater a meta deste mês.
A projeção usa o ritmo de vendas até a data de referência. O consultor vê a revenda em risco enquanto ainda dá tempo de ligar.
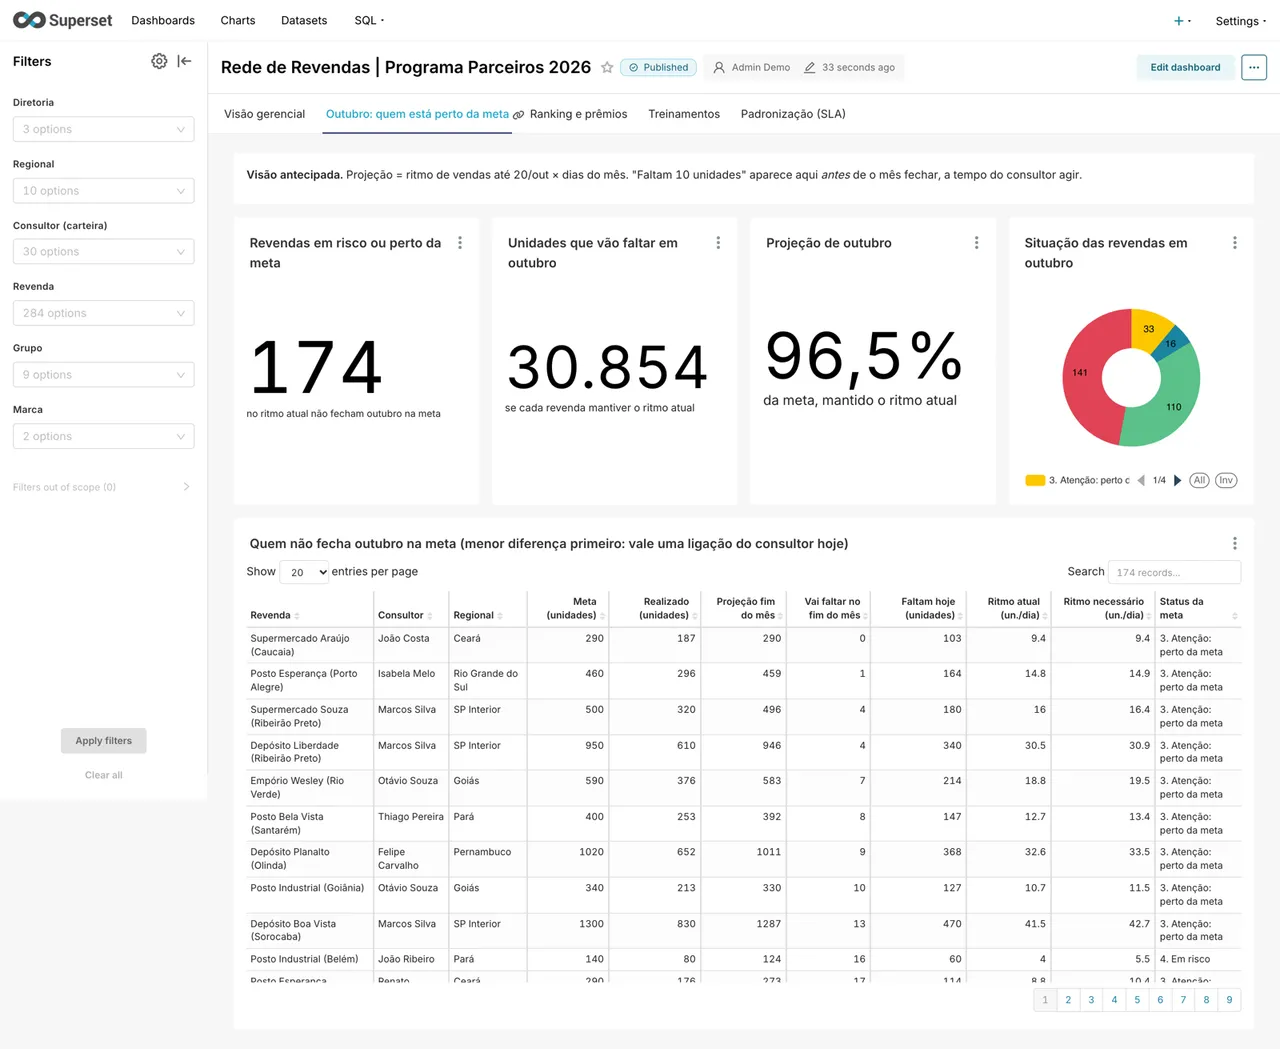
A lista começa por quem está mais perto da meta, porque ali uma ligação ainda muda o resultado.
Também respondi sete perguntas avulsas direto no SQL, sem passar pelo painel. Uma delas cruzou treinamento e vendas.
A correlação ficou perto de zero nesses dados. Por isso o painel não promete que treinar aumenta a venda.
Resultado
Publiquei o projeto no GitHub em outubro de 2026, com o código, os dados e o passo a passo para rodar.
Quem clona o repositório sobe o banco e o painel com um comando no Docker.
O painel responde as cinco perguntas do time comercial, em 27 gráficos e cinco abas.
Num cenário real, o próximo passo seria dar a cada consultor acesso só à própria carteira. Outro seria mandar por e-mail a lista de revendas em risco.
O projeto deixou um caminho completo, da tabela bruta ao painel, guardado em código.